
PDF에서 텍스트 추출
PDF의 모든 텍스트를 일반 텍스트 파일로 복사합니다. 워터마크가 없는 빠른 무료 온라인 PDF를 TXT로 변환합니다.
또는 여기에 PDF를 드롭하세요
선택한 파일이 없습니다.
비공개 및 단기: 모든 업로드는 마지막으로 연 후 2시간이 지나면 자동으로 삭제됩니다.
단계별로
PDF에서 텍스트 추출: 단계별
Upload and download the .txt — no settings, no formatting decisions.
- 1
PDF 업로드
문서를 드롭하세요. 화면은 의도적으로 최소화되었습니다. 이전이나 이후에 구성할 것이 없습니다. 파일은 2시간 후에 삭제됩니다.
읽을 PDF를 선택하세요 - 2
텍스트 추출을 누르세요.
하나의 버튼: 모든 페이지를 순서대로 읽고 일반 텍스트로 작성합니다. 실제 텍스트는 있는 그대로 나옵니다. 스캔한 페이지는 텍스트 레이어가 없는 그림이므로 읽을 내용이 없습니다.
- 3
Download the .txt
The ready page hands back a plain text file — in our test the four-page document arrived as a 9.1 KB .txt that opens in any editor on any system.
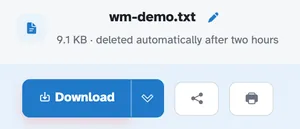
- Plain .txt back
전체 문서는 텍스트 파일로 작성되어 어디에나 붙여넣을 수 있습니다.
- 페이지별로 순서대로
페이지는 읽는 순서에 따라 차례대로 작성됩니다.
- 복사-붙여넣기 준비됨
텍스트는 마크업이나 래퍼 없이 일반 단락으로 도착합니다.
- 스캔에 대해 솔직하게
스캔한 페이지는 텍스트 이미지입니다. 변환 시 읽을 내용이 없으며 그렇게 말합니다.
- 어디서나 열립니다
.txt reads in every editor on every system, forever.
- 기본적으로 비공개
계정도, 워터마크도 없습니다. 모든 파일은 2시간 후에 자동으로 삭제됩니다.
선택됨: