
PDF からテキストを抽出
PDF からすべてのテキストをプレーン テキスト ファイルにコピーします。透かしのない、高速で無料のオンライン PDF から TXT へのコンバーター。
またはここに PDF をドロップします
ファイルが選択されていません
非公開で有効期限が短い: すべてのアップロードは、最後に開いてから 2 時間後に自動的に消去されます。
一歩ずつ
PDF からテキストを抽出: ステップバイステップ
Upload and download the .txt — no settings, no formatting decisions.
- 1
PDF をアップロードする
ドキュメントをドロップします。画面は意図的に最小限に抑えられており、前後に設定する必要はありません。ファイルは 2 時間後に削除されます。
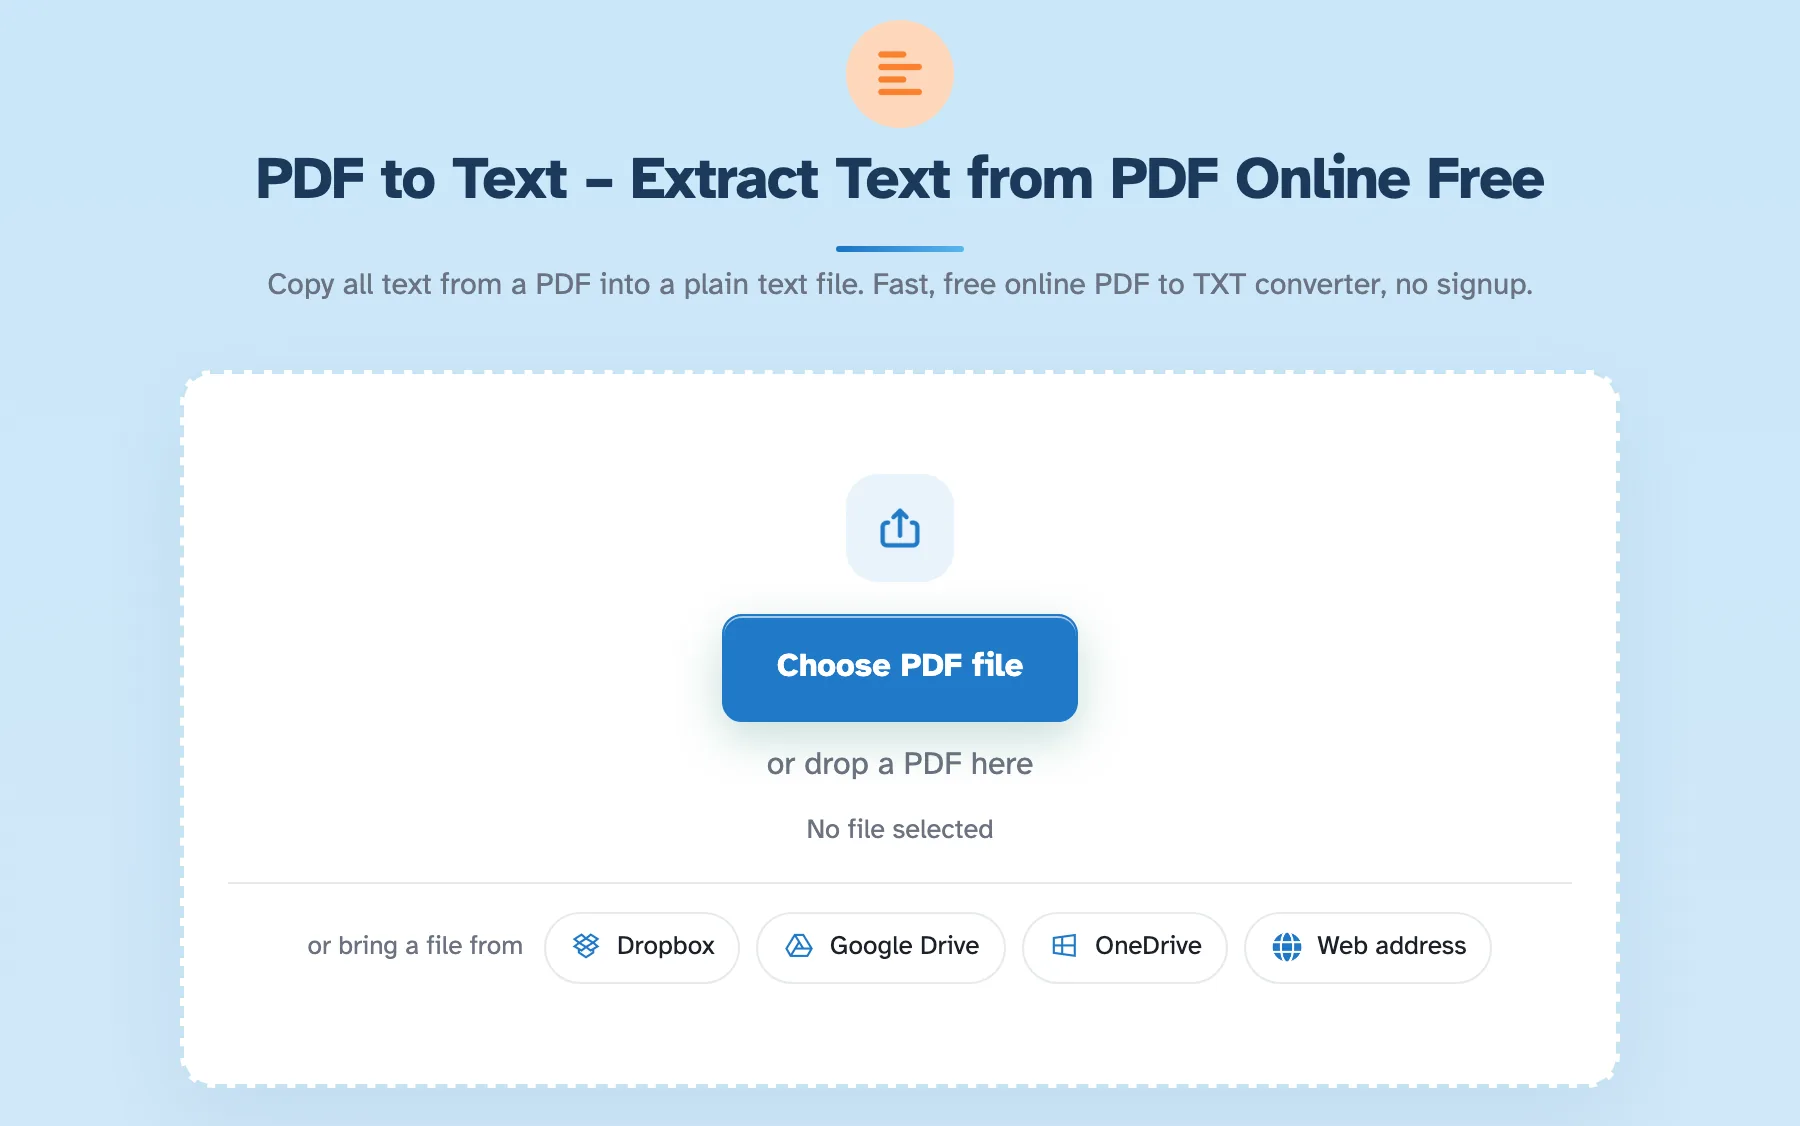
読む PDF を選択してください - 2
テキストの抽出を押します
ボタン 1 つ: すべてのページが順番に読み取られ、プレーン テキストとして書き出されます。実際のテキストはそのまま出力されます。スキャンされたページはテキストレイヤーのない画像なので、読み取るものは何もありません。
- 3
Download the .txt
The ready page hands back a plain text file — in our test the four-page document arrived as a 9.1 KB .txt that opens in any editor on any system.
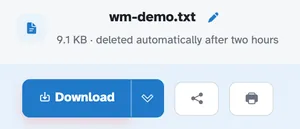
- Plain .txt back
文書全体はテキスト ファイルとして書き出され、どこにでも貼り付けることができます。
- ページごとに順番に
ページは、読み取り順序に従って次々に書き込まれます。
- コピー&ペーストの準備ができました
テキストはプレーンな段落として届きます。マークアップやラッパーはありません。
- スキャンについては正直
スキャンされたページはテキストの画像です。変換では読み取るものは何もありません。
- どこでも開きます
.txt reads in every editor on every system, forever.
- デフォルトでは非公開
アカウントもウォーターマークもありません。すべてのファイルは 2 時間後に自動的に削除されます。
選択済み: